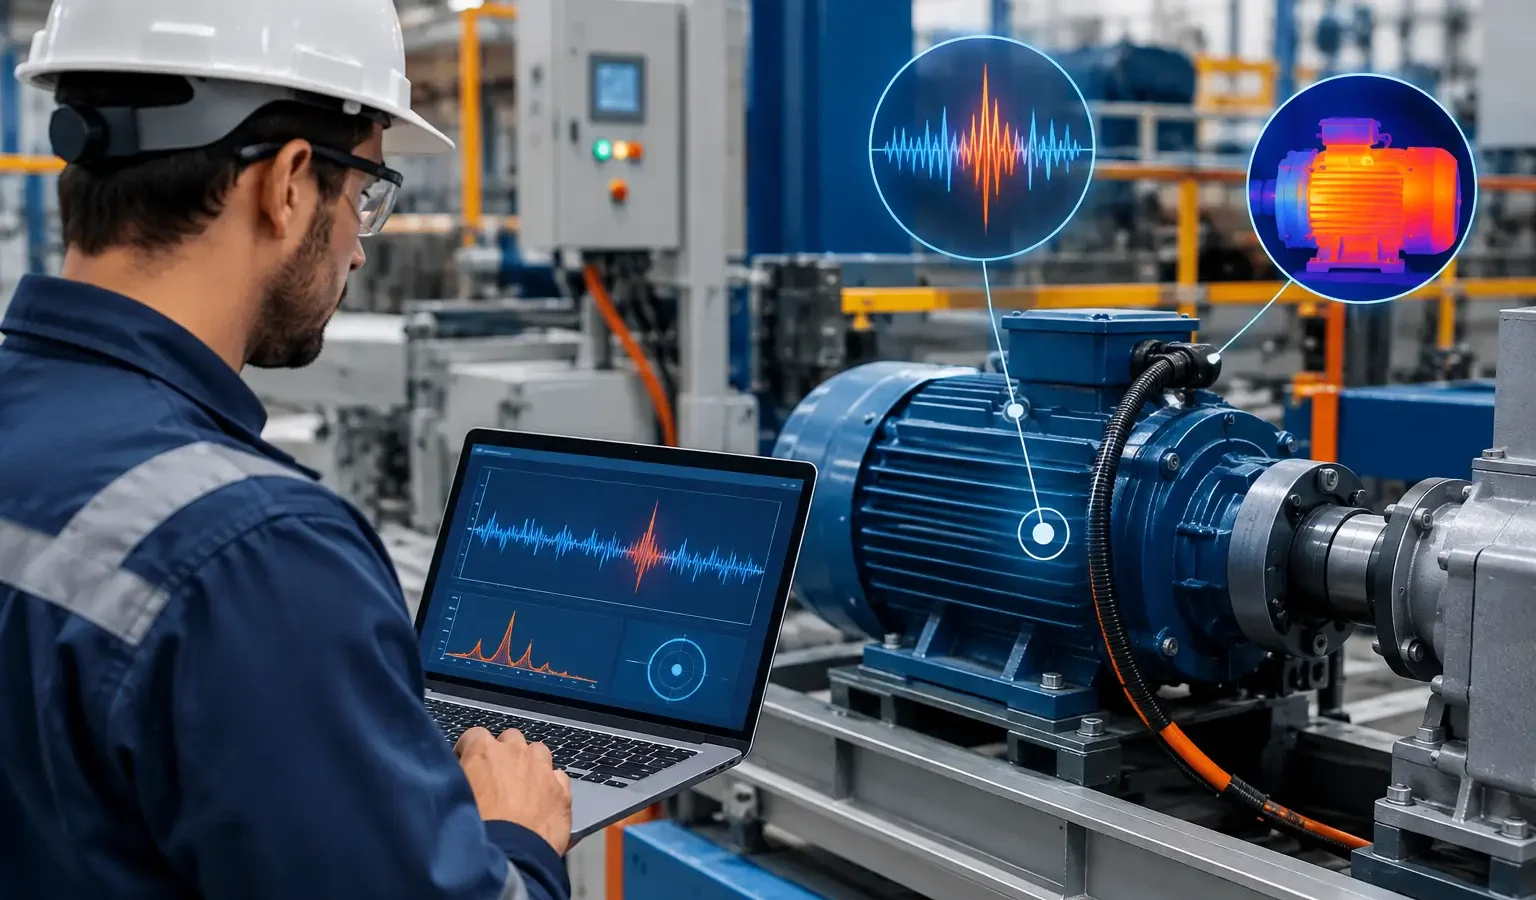
Um motor que passa a demandar mais corrente, uma bomba com vibração crescente ou uma válvula que demora alguns segundos além do padrão para responder podem parecer ocorrências isoladas. Em uma planta industrial, porém, esses sinais frequentemente antecedem perdas de rendimento, falhas funcionais e paradas não planejadas. A detecção de anomalias em equipamentos industriais permite identificar esses desvios antes que se transformem em uma ocorrência crítica, desde que os dados sejam confiáveis e interpretados no contexto real do processo.
O objetivo não é gerar mais alarmes na sala de controle. É diferenciar uma variação aceitável de uma condição que exige análise, planejamento de manutenção ou intervenção segura. Para gestores, engenharia e manutenção, essa capacidade melhora a priorização dos recursos e reduz decisões baseadas apenas em urgência ou percepção de campo.
O que caracteriza uma anomalia industrial
Anomalia não é sinônimo de defeito. Um defeito pode ser a consequência de uma condição anormal que não foi identificada a tempo. Na prática, uma anomalia é um comportamento que se distancia do padrão esperado para determinado equipamento, processo ou condição operacional.
Esse padrão precisa considerar a realidade da aplicação. A corrente de um motor, por exemplo, varia de acordo com carga, regime de operação, temperatura ambiente, produto processado e condição mecânica do conjunto. Portanto, estabelecer um limite fixo sem considerar essas variáveis pode gerar falsos alarmes ou, no sentido oposto, esconder uma degradação gradual.
Em equipamentos rotativos, desvios podem surgir em vibração, temperatura de mancais, pressão, vazão, rotação e consumo elétrico. Em sistemas de processo, é comum observar diferenças entre o comando enviado pelo CLP e a resposta efetiva em campo, oscilações de malha de controle, tempos de ciclo fora do esperado e acionamentos repetitivos de proteções. Em painéis elétricos, aquecimento, desequilíbrio de corrente, falhas de comunicação e atuações recorrentes de dispositivos de proteção também merecem análise técnica.
O ponto central é que uma variável isolada raramente explica o problema. A leitura ganha valor quando é correlacionada com o estado operacional do ativo e com outras medições disponíveis no sistema.
Por que a detecção de anomalias em equipamentos industriais exige contexto
Muitas plantas já possuem CLPs, IHMs, inversores de frequência, relés inteligentes e sistemas supervisórios capazes de registrar uma quantidade significativa de informações. Ainda assim, ter dados não significa necessariamente ter diagnóstico.
Uma elevação de temperatura pode ser normal após uma partida, mas preocupante em operação estabilizada. Uma queda de vazão pode indicar desgaste de bomba, obstrução na linha, alteração no fluido ou simplesmente uma mudança programada na demanda do processo. Sem contexto operacional, a equipe pode atuar no sintoma errado e aumentar o tempo de indisponibilidade.
Por isso, a estratégia de detecção deve combinar três elementos: instrumentação adequada, histórico confiável e regras de análise coerentes com o processo. Em aplicações mais maduras, modelos estatísticos ou algoritmos podem ajudar a reconhecer padrões complexos. Mas eles não substituem o conhecimento de engenharia sobre o equipamento, sua criticidade e seus modos de falha mais prováveis.
Também há um limite prático. Nem todo ativo exige o mesmo nível de monitoramento. Um equipamento reserva, com troca rápida e baixo impacto produtivo, pode demandar uma abordagem diferente daquela aplicada a um transportador crítico, uma estação elevatória, um moinho ou um sistema de exaustão essencial à operação. O investimento deve acompanhar o risco operacional e a consequência de uma falha.
Da medição à decisão de manutenção
Uma arquitetura eficiente começa com a definição do que precisa ser monitorado. Essa decisão deve partir da análise do processo e da criticidade dos ativos, não apenas da disponibilidade de sensores no mercado. Em seguida, é necessário verificar se os sinais existentes têm resolução, escala, estabilidade e frequência de aquisição compatíveis com o fenômeno que se deseja identificar.
Dados de campo inconsistentes comprometem qualquer camada posterior de análise. Sensores mal posicionados, transmissores sem verificação metrológica, tags sem padronização, falhas intermitentes de rede e registros sem referência de tempo podem produzir conclusões equivocadas. Antes de discutir análises avançadas, vale revisar a qualidade da base instalada.
No nível de automação, o CLP pode comparar condições de processo, reconhecer sequências fora do padrão e registrar eventos relevantes. A IHM deve apresentar informações úteis ao operador, evitando telas carregadas de alarmes sem prioridade. Já o supervisório tem papel importante na visualização de tendências, no histórico, na rastreabilidade de eventos e na análise de correlação entre variáveis.
O melhor resultado aparece quando o alerta se converte em uma ação definida. Se a pressão de sucção de uma bomba se afasta gradualmente do comportamento esperado, por exemplo, a equipe precisa saber quem avalia a ocorrência, quais variáveis devem ser verificadas, quando a inspeção deve ser programada e qual condição exige escalonamento. Um alarme sem procedimento associado apenas transfere incerteza para a operação.
Alarmes não são diagnóstico
Configurar limites alto e baixo é necessário, mas não basta. Alarmes excessivos geram fadiga, reduzem a atenção do operador e tornam mais difícil reconhecer eventos realmente relevantes. A gestão adequada considera prioridade, persistência, condição de habilitação, retorno à normalidade e relação com o estado operacional do equipamento.
Também é recomendável distinguir entre alarme de processo, aviso de desempenho e indicação de manutenção. Um desvio que não exige parada imediata pode ser decisivo para programar uma inspeção durante uma janela de produção. Essa separação ajuda a preservar a segurança operacional sem transformar cada variação em uma emergência.
Critérios práticos para priorizar ativos e variáveis
Uma implantação consistente não precisa começar por toda a planta. Em muitos casos, o caminho mais seguro é selecionar um conjunto de ativos críticos e estabelecer uma referência de desempenho. A priorização deve considerar impacto na produção, riscos à segurança, tempo de reposição, existência de redundância, custo de parada e histórico de falhas.
Para cada ativo priorizado, a engenharia deve definir quais sinais representam melhor a sua condição. Em um conjunto motobomba, isso pode envolver pressão, vazão, corrente, vibração, temperatura e status de válvulas. Em um forno ou sistema térmico, a análise pode depender de temperaturas por zona, consumo energético, pressão, posição de damper e comportamento das malhas de controle.
A referência inicial pode ser construída a partir de dados históricos de períodos estáveis, desde que esses registros sejam representativos. Quando o histórico não existe ou é insuficiente, testes controlados, inspeções técnicas e observação de campo ajudam a estabelecer a linha de base. O processo exige revisão periódica, pois alterações de produto, capacidade, equipamentos e lógica de controle podem modificar o comportamento normal da operação.
Integração, retrofit e segurança na execução
Em plantas com sistemas legados, a detecção de anomalias muitas vezes depende de integrar equipamentos de gerações diferentes. É possível aproveitar sinais já disponíveis em CLPs e inversores, instalar instrumentação complementar e consolidar dados em uma camada supervisória. Entretanto, a viabilidade depende da arquitetura existente, dos protocolos de comunicação, da condição dos painéis e das restrições de parada da planta.
Um retrofit bem conduzido precisa preservar a continuidade operacional e definir claramente os pontos de interface. Alterações em painéis, circuitos de comando, redes industriais e lógicas de controle devem ser projetadas, testadas e comissionadas com rastreabilidade. Em intervenções elétricas e de máquinas, os requisitos aplicáveis de segurança, incluindo NR10 e NR12 quando pertinentes ao escopo, devem ser avaliados por profissionais habilitados e conforme as condições reais da instalação.
Não existe promessa responsável de conformidade ou de eliminação total de falhas sem diagnóstico técnico. O que existe é um processo de engenharia que identifica riscos, define prioridades e executa melhorias com critérios verificáveis.
O papel da engenharia aplicada na confiabilidade
A detecção de anomalias entrega valor quando deixa de ser apenas uma função do sistema e passa a integrar a rotina de operação e manutenção. Isso requer parâmetros bem definidos, equipes treinadas, documentação atualizada e comunicação entre produção, elétrica, automação e manutenção mecânica.
A Seabra Automação Industrial atua na análise e integração de sistemas de controle, supervisão, painéis e instrumentação para que informações de campo possam apoiar decisões técnicas reais. Cada projeto deve partir do processo produtivo, da criticidade dos equipamentos e das limitações da planta, com escopo definido para implantação, testes, comissionamento e suporte.
A condição anormal mais valiosa não é a que produz o maior número de alarmes, mas a que chega cedo o suficiente para permitir uma decisão segura e planejada. Se a sua planta precisa avaliar sinais, ativos críticos ou possibilidades de integração, solicite um diagnóstico técnico ou orçamento pelo WhatsApp da Seabra Automação Industrial.
Precisa aplicar isso na sua planta?
A equipe da SEABRA pode avaliar seu cenário e indicar o próximo passo técnico.
Falar com a equipe técnica